分布式锁详解
分布式锁是一种在分布式系统中用于控制并发访问的机制。在分布式系统中,多个客户端同时对同一个资源进行访问时,容易出现数据不一致的问题。分布式锁的作用就是确保同一时刻只有一个客户端能够对某个资源进行访问,以避免数据不一致的问题。本文将详细介绍分布式锁的原理、应用场景和常见实现方式。
原理
在单机环境中,通常可以使用互斥锁(Mutex)或者读写锁(RWLock)来控制并发访问。但在分布式系统中,由于存在多个节点和网络通信延迟等问题,使用互斥锁或读写锁就不再适用。这时就需要使用分布式锁来控制并发访问。
分布式锁通常基于某种共享存储机制实现,比如分布式缓存、数据库或者文件系统等。具体实现方式可以分为乐观锁和悲观锁两种。
乐观锁是指在每次访问共享资源时,都假设其他节点不会同时修改该资源,并在访问前检查是否有其他节点对该资源进行了修改。如果检查发现有其他节点对该资源进行了修改,那么当前节点会进行回滚并重试,直到成功为止。乐观锁的优点是不需要加锁,因此可以提高系统的并发性能,缺点是可能会导致频繁的重试操作,增加系统负担。
悲观锁是指在每次访问共享资源时,都假设其他节点会同时修改该资源,并对该资源进行加锁。加锁可以采用分布式锁算法,比如基于共享缓存的实现方式,比如Redis等。加锁后,其他节点就无法对该资源进行修改,直到当前节点完成操作并释放锁。悲观锁的优点是保证数据一致性,缺点是加锁操作可能会影响系统的性能。
应用场景
分布式锁通常用于以下场景:
- 数据库并发控制:在分布式数据库中,多个节点同时对同一个表进行操作时,可能会出现并发冲突的问题。使用分布式锁可以确保同一时刻只有一个节点能够对该表进行操作,以避免并发冲突。
- 分布式缓存:在分布式缓存中,多个节点同时对同一个缓存进行操作时,可能会出现数据不一致的问题。使用分布式锁可以确保同一时刻只有一个节点能够对该缓存进行操作,
以避免数据不一致的问题。
分布式任务调度:在分布式任务调度中,多个节点可能同时执行同一个任务,使用分布式锁可以确保同一时刻只有一个节点能够执行该任务,以避免重复执行的问题。
常见实现方式
基于Redis实现分布式锁
Redis是一种高性能的键值存储系统,支持多种数据结构,包括字符串、哈希表、列表、集合、有序集合等。Redis支持多种分布式锁算法,比如SETNX、BLPOP、BRPOP等。
其中,SETNX命令是Redis中最常用的分布式锁算法之一。该算法的实现思路是在Redis中创建一个键值对,其中键表示锁的名称,值表示锁的拥有者。如果该键不存在,则创建该键,并将其值设置为当前节点的ID。如果该键已经存在,则说明锁已经被其他节点占用,当前节点需要等待一段时间后再尝试获取锁。当当前节点完成对共享资源的访问后,需要将该键值对删除,以释放锁。
import redis.clients.jedis.Jedis;
import redis.clients.jedis.params.SetParams;

public class RedisLock {
    private static final String LOCK_KEY_PREFIX = "lock:";
    private static final int DEFAULT_EXPIRE_TIME = 60 * 1000; // 默认过期时间为60秒
    private String lockKey;
    private String lockValue;
    private Jedis jedis;

    public RedisLock(String key) {
        this.lockKey = LOCK_KEY_PREFIX + key;
        this.jedis = new Jedis("localhost", 6379); // 建立Redis连接
        this.lockValue = Thread.currentThread().getName();
    }

    public boolean lock() {
        SetParams params = SetParams.setParams().nx().px(DEFAULT_EXPIRE_TIME);
        String result = jedis.set(lockKey, lockValue, params);
        return "OK".equals(result);
    }

    public boolean unlock() {
        String luaScript = "if redis.call(\"get\",KEYS[1]) == ARGV[1] then return redis.call(\"del\",KEYS[1]) else return 0 end";
        Object result = jedis.eval(luaScript, 1, lockKey, lockValue);
        return "OK".equals(result);
    }
}
在Redis实现分布式锁的示例代码中,我们使用了Jedis客户端库连接Redis服务器,调用set方法实现获取锁操作,其中SetParams对象用于指定Redis的NX和PX参数,保证分布式锁的正确性和安全性。同时,我们使用Lua脚本实现了释放锁的操作,保证了多个Redis命令的原子性。注意,在实际应用中,应该根据具体的应用场景和业务需求调整过期时间等参数,以保证分布式锁的高效性和可靠性。
基于ZooKeeper实现分布式锁
ZooKeeper是一种开源的分布式协调服务,可以用于实现分布式锁、配置管理、命名服务等。ZooKeeper的分布式锁算法基于节点顺序(Node Sequence)和临时节点(Ephemeral Node)两种概念。
其中,节点顺序是指在ZooKeeper中创建节点时,会自动为每个节点分配一个序号,序号越小的节点优先级越高。临时节点是指在创建节点时,可以指定该节点的生命周期,当节点的创建者与ZooKeeper的连接断开后,该节点会被自动删除。
ZooKeeper的分布式锁算法基于节点顺序和临时节点的特性,实现过程如下:
- 在ZooKeeper中创建一个父节点,并为该节点指定节点顺序和临时节点属性。
- 每个节点在该父节点下创建一个临时顺序节点,并等待锁。
- 当节点需要获取锁时,它会获取父节点下的所有节点,并判断自己是否为节点顺序最小的节点。
- 如果自己是节点顺序最小的节点,则获取到了锁;否则,节点需要等待直到自己成为节点顺序最小的节点。
- 当节点完成对共享资源的访问后,它会删除自己创建的临时顺序节点,以释放锁。
- 以下是基于ZooKeeper实现分布式锁的示例代码:
import java.util.List;
import org.apache.zookeeper.KeeperException;
import org.apache.zookeeper.WatchedEvent;
import org.apache.zookeeper.Watcher;
import org.apache.zookeeper.ZooKeeper;
import org.apache.zookeeper.CreateMode;

public class ZooKeeperLock implements Watcher {
    private ZooKeeper zk;
    private String lockPath;
    private String myZnode;

    public ZooKeeperLock(String hosts, String lockPath) {
        try {
            this.zk = new ZooKeeper(hosts, 3000, this);
            this.lockPath = lockPath;
            // 创建锁节点
            if (zk.exists(lockPath, false) == null) {
                zk.create(lockPath, new byte[0], ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.PERSISTENT);
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }

    public boolean acquire() {
        try {
            // 创建临时顺序节点
            myZnode = zk.create(lockPath + "/lock_", new byte[0], ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.EPHEMERAL_SEQUENTIAL);
            // 获取所有子节点
            List<String> children = zk.getChildren(lockPath, false);
            // 排序子节点
            Collections.sort(children);
            // 获取最小的子节点
            String minNode = children.get(0);
            // 如果是第一个节点,则获取到了锁
            if (myZnode.equals(lockPath + "/" + minNode)) {
                return true;
            } else {
                // 如果不是第一个节点,则监听前一个节点的删除事件
                int index = Collections.binarySearch(children, myZnode.substring(myZnode.lastIndexOf("/") + 1));
                String watchNode = children.get(index - 1);
                Stat stat = zk.exists(lockPath + "/" + watchNode, this);
                if (stat != null) {
                    synchronized (this) {
                        this.wait();
                    }
                }
                return true;
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
        return false;
    }

    public void release() {
        try {
            zk.delete(myZnode, -1);
            zk.close();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }

    public void process(WatchedEvent event) {
        synchronized (this) {
            this.notifyAll();
        }
    }
}
注意,Java实现的分布式锁示例代码使用了java.util.Collections类对节点进行排序,因此需要将其导入。另外,为了方便演示,代码中省略了异常处理和其他细节处理。在实际应用中,应根据具体的需求和环境选择合适的分布式锁实现方式,并进行细致的优化和调整。
下面是基于Zookeeper和Redis实现分布式锁的对比:
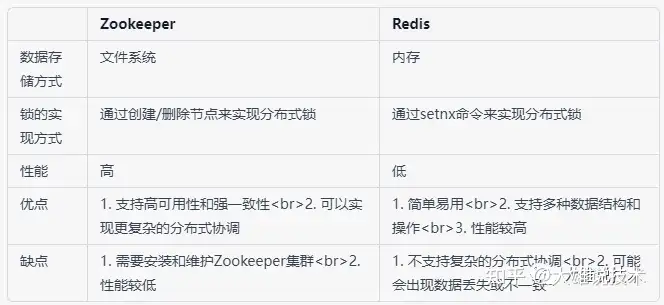
总的来说,基于Zookeeper实现分布式锁可以实现强一致性和高可用性,适合于对数据一致性要求比较高的场景,但是需要安装和维护Zookeeper集群,性能相对较低。而基于Redis实现分布式锁则更加简单易用,性能较高,适合于对数据一致性要求不是特别高的场景,但是可能会出现数据丢失或不一致的情况。选择哪种实现方案应该根据具体的业务需求和应用场景来进行权衡。
转自:https://zhuanlan.zhihu.com/p/623265941